Tous les projetsMa contribution
01 / réalisation

Uni-Translate

Produit personnel · IA vocale

Traduire une conversation demande de coordonner l’écoute, le texte et la voix en temps réel. Avec Uni-Translate, je travaille toute la chaîne, de l’audio entrant à la voix traduite.

Mon rôleIA vocale, architecture et expérience produit
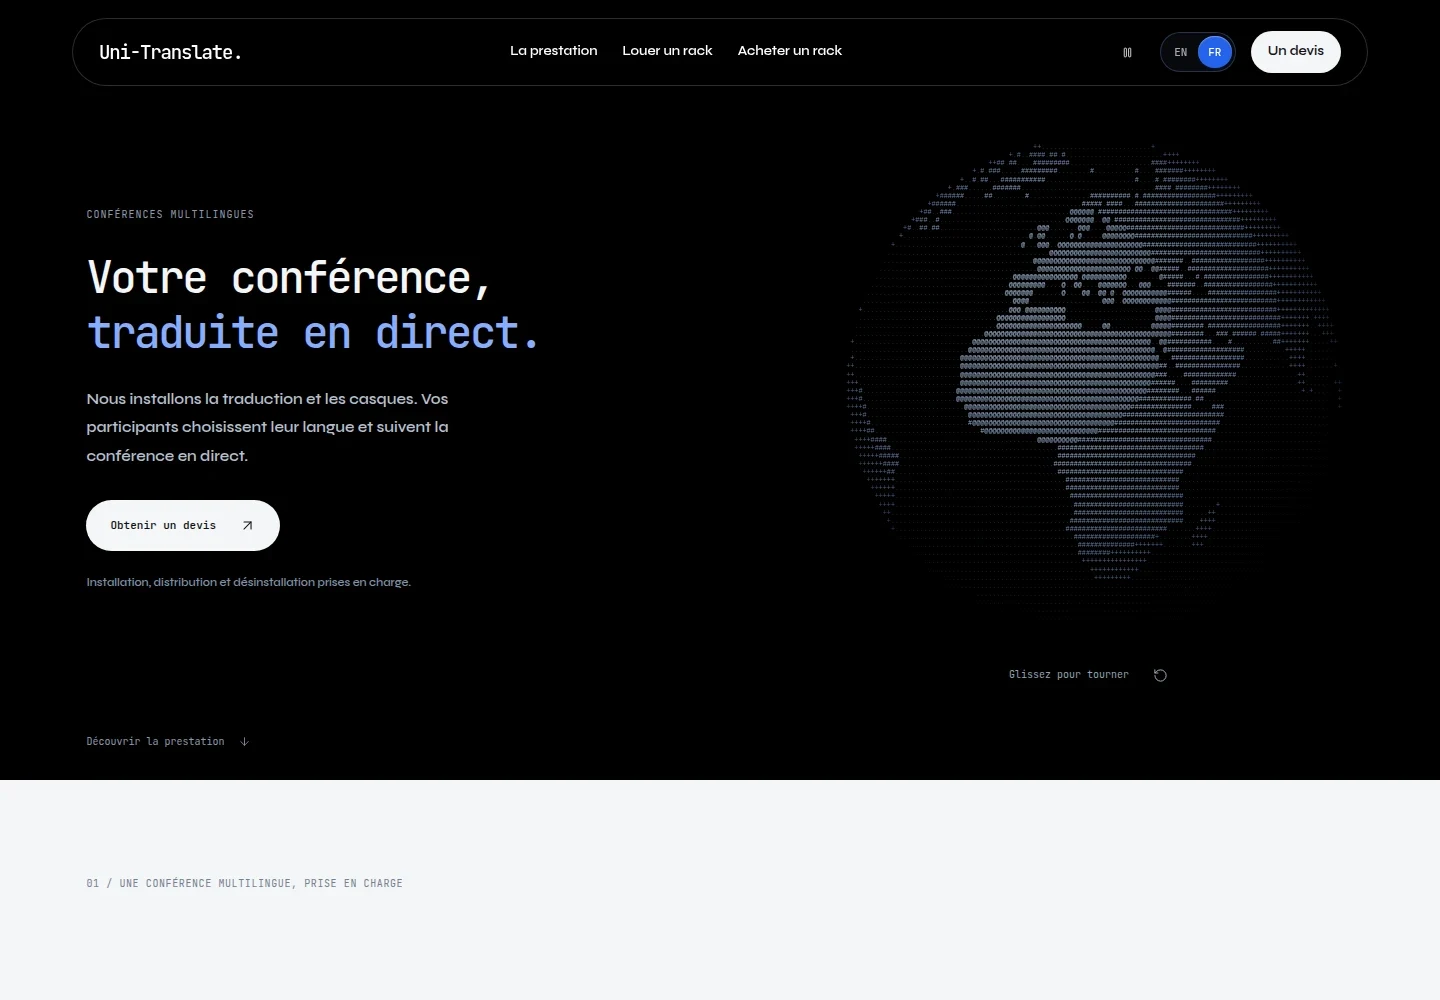
uni-translate.frLe site, en un regard
Interface publique du produit de traduction vocale en temps réel Uni-Translate

Le choix technique

Python et FastAPI pour orchestrer le pipeline vocal en streaming, avec des traitements GPU isolés.

Découvrir le site
Architecture et choix techniques

Du flux audio à la voix traduite.

FastAPI reçoit le flux audio en continu par WebSocket. J’orchestre ensuite en Python la transcription, la traduction et la synthèse vocale : chaque étape transmet son résultat à la suivante. Ces traitements sont répartis dans des processus séparés, avec leurs propres dépendances, puis réunis dans une image Docker pour être exécutés sur GPU.

Décider quand faire parler la traduction.

Une transcription peut encore changer pendant que la personne parle. Le scoreur estime le risque de lancer la voix trop tôt à partir de la stabilité du texte et de la traduction. Selon le profil, il autorise un préfixe ou attend le segment final. La sortie audio conserve ensuite l’ordre des fragments et utilise une référence vocale validée.

Agrandir la capture

Ma contribution

Le besoin

Dans une conférence en direct, attendre la fin d’une longue prise de parole retarde la traduction. Démarrer la voix trop tôt risque de prononcer un texte que la reconnaissance va encore corriger. Uni-Translate est mon produit personnel pour travailler ce compromis à chaque étape du flux vocal.

De la prise de parole à la voix traduite

Deux états du texte coexistent pendant la prise de parole. La transcription et la traduction continuent de se préciser tandis que le scoreur choisit ce qui peut passer vers la voix. Après synthèse, les fragments doivent être restitués dans leur ordre de lecture.

Comment fonctionne le flux

  1. Recevoir l’audio

    FastAPI reçoit le flux de la session par WebSocket.

  2. Transcrire et traduire

    Les moteurs produisent du texte qui se précise à mesure que la personne parle.

  3. Décider de l’émission

    Le scoreur observe la stabilité de la transcription et de la traduction.

  4. Synthétiser et restituer

    La voix de référence sert à produire les fragments, envoyés dans l’ordre.

Quand lancer la synthèse ?

Le passage est stable
Le préfixe validé part vers la synthèse pendant que la personne parle.
Le texte peut encore changer
Le système attend la fin du segment avant de le faire entendre.

Réalisations

  1. Recevoir le son pendant la prise de parole

    J’ai relié la réception audio par WebSocket à une session FastAPI. La transcription, la traduction et la synthèse se transmettent leurs résultats au fil de la session, pendant que le son continue d’arriver.

  2. Isoler les moteurs de traitement

    J’ai réparti les traitements Python dans des processus séparés qui gardent leurs propres dépendances. Une image Docker les réunit pour l’exécution sur GPU, avec une orchestration commune pour le flux de la session.

  3. Décider quand lancer la synthèse

    J’ai travaillé sur un scoreur qui observe la stabilité de la transcription et de la traduction. Selon le profil, il peut autoriser la partie déjà jugée stable ou attendre la fin du segment avant de produire l’audio.

  4. Préserver la continuité de la voix

    J’ai travaillé sur l’ordre de restitution des fragments et l’utilisation d’une référence vocale validée. Si une révision touche un passage déjà prononcé, la suite attend avant de repartir.

My contribution

The problem

In a live conference, waiting for a speaker to finish a long turn delays the translation. Starting too early can voice words that speech recognition is about to revise. Uni-Translate is my personal product for working through that trade-off across the speech pipeline.

From the speaker’s audio to translated speech

Two states of the text coexist while the speaker is talking. The transcript and translation keep updating while the scorer chooses what can be voiced. After synthesis, audio fragments have to play in their reading order.

How the flow works

  1. Receive audio

    FastAPI receives the session stream over WebSocket.

  2. Transcribe and translate

    The engines produce text that updates as the speaker continues.

  3. Decide what to release

    The scorer tracks how stable the transcript and translation are.

  4. Generate and play speech

    Audio is generated with a reference voice and delivered in order.

When does synthesis start?

The passage is stable
The validated prefix goes to speech synthesis while the speaker continues.
The text can still change
The system waits for the segment to end before voicing it.

What I did

  1. Receive audio as the speaker talks

    I connected audio arriving over WebSocket to a FastAPI session. Transcription, translation and text-to-speech pass results along while new audio continues to arrive.

  2. Isolate the processing engines

    I put the Python processing stages in separate processes so they can keep their own dependencies. A Docker image packages them together for GPU execution, with shared orchestration for each session.

  3. Decide when to start speaking

    I worked on a scorer that looks at how stable the transcript and translation are. Depending on the session profile, it can release the portion judged stable or wait until the segment is final before generating audio.

  4. Keep the voice consistent across segments

    I worked on delivering segments in order and using a validated reference voice. If a revision affects words already spoken, the system holds the next segment before resuming.

Parlons de votre idée

Vous pouvez m’écrire àbaptiste.avert@gmail.com